В 2026 году для первого запуска на ПК лучше выбрать Qwen, gpt-oss или DeepSeek. Конкретная версия зависит от объема оперативной памяти.
Локальная нейросеть отвечает прямо на компьютере и может работать без интернета. Для ноутбука с 8 ГБ памяти выбирайте небольшую текстовую модель. При 16 ГБ можно запускать более сильные версии для текста и кода.
Лучшие нейросети для установки на ПК
Qwen — лучший универсальный вариант для новичка. DeepSeek подробнее разбирает сложные вопросы, а gpt-oss дает локальную ИИ-модель OpenAI. Чем больше модель, тем больше памяти ей нужно и тем медленнее она работает на слабом компьютере. Открытые ИИ-модели используют 79% разработчиков, которые добавляют ИИ в приложения.
Какие локальные нейросети выбрать для установки на ПК:
| Нейросеть | Что умеет | Оперативная память |
|---|---|---|
| 1. Qwen | Написать текст, объяснить тему, помочь с кодом | 16-32 ГБ для 9B |
| 2. gpt-oss | Разобрать сложный вопрос без отправки запроса в ChatGPT | 24-32 ГБ для 20B |
| 3. DeepSeek | Решить задачу по шагам, найти ошибку в коде | 16 ГБ для 8B |
| 4. GLM | Разобрать текст и подключить модель к ИИ-агенту | 32+ ГБ для 4.7 Flash |
| 5. Gemma | Обсудить документ и прочитать изображение | 16-32 ГБ для 4 12B |
| 6. Mistral | Сократить текст, составить письмо, разобрать скриншот | 16 ГБ для Ministral 3 8B |
| 7. Phi | Объяснить формулу или небольшой фрагмент программы | 8-16 ГБ для Mini |
| 8. Llama* | Запустить текстовый чат в популярных локальных программах | 16 ГБ для 3.1 8B |
| 9. Qwen Coder | Написать код и изменить несколько файлов | 32+ ГБ для 30B |
| 10. Devstral | Исправить проект и проверить изменения через ИИ-агента | 32+ ГБ для Small 2 |
Присоединяйтесь к ✨19 000+ подписчиков в телеграм-канале Бегин (или макс-канал), где я рассказываю, как использовать ИИ в бизнесе.
1. Qwen — писать тексты, разбирать документы, работать с кодом
Для универсального локального чат-бота подойдут Qwen3.5 4B, Qwen3.5 9B и Qwen3.5 27B от Alibaba. 9B — разумная отправная точка для ПК с 16 ГБ памяти, а 4B стоит выбрать, если компьютер слабее.
Qwen пишет по-русски, объясняет сложные темы, помогает с кодом и разбирает изображения. Китайские нейросети используют 1 млрд человек в месяц по всему миру, а семейство Qwen стало одним из самых заметных вариантов для локального запуска.
Для запуска подойдет Ollama или LM Studio. Файлы версий 4B и 9B занимают 3.4 и 6.6 ГБ. Для 27B лучше иметь не менее 32 ГБ оперативной памяти. В каталоге выбирайте вариант Instruct или Chat: он уже умеет отвечать на вопросы. Версия Base — это заготовка для разработчиков, а не готовый чат-бот.
Плюсы:
- Пишет и отвечает на русском языке.
- Разбирает текст и изображения в одном чате.
- Предлагает версии для разных компьютеров.
- Работает в популярных программах для локального ИИ.
Минусы:
- Версия 27B требует заметно больше памяти, чем 9B.
- Большие изображения дополнительно занимают память.
- Без подключения поиска не получает свежие сведения из интернета.
- Режим подробных рассуждений увеличивает время ожидания ответа.
2. gpt-oss — модель OpenAI без облачного ChatGPT
gpt-oss-20b и gpt-oss-120b — открытые текстовые модели OpenAI. Для домашнего компьютера интереснее 20b: файл в Ollama занимает 14 ГБ, тогда как 120b весит 65 ГБ.
gpt-oss отвечает на сложные вопросы и пишет код. Сама ИИ-модель не запускает программу: она только предлагает команды и изменения. Для проверки кода понадобится редактор или другая программа с доступом к Python.
Версию 20B можно запустить при 16 ГБ свободной памяти, но Windows и другие программы уже занимают ее часть. Поэтому для обычного ПК лучше иметь 24-32 ГБ. Версии 120B требуется оборудование уровня рабочей станции, например видеокарта с 80 ГБ собственной памяти. Место на диске отвечает только за хранение файла и не гарантирует быструю работу.
Плюсы:
- Работает без учетной записи ChatGPT после установки.
- Меняет глубину рассуждений под сложность вопроса.
- Подключается к программам, которые выполняют действия.
- Не требует платы за каждый локальный запрос.
Минусы:
- Не принимает изображения как входные данные.
- Не заменяет все функции приложения ChatGPT.
- 120b не рассчитана на обычный ноутбук.
- Для работы с файлами и инструментами нужна подходящая программа.
3. DeepSeek — решает задачи по шагам и объясняет код
Для ПК стоит рассмотреть DeepSeek-R1-0528-Qwen3-8B, R1 Distill Qwen 14B и R1 Distill Qwen 32B. Это компактные модели с навыками рассуждения DeepSeek, а не полная копия облачного чат-бота.
Distill — это уменьшенная версия большой нейросети. Она занимает меньше памяти, но сохраняет умение разбирать задачу по шагам. Ответы часто получаются длинными, поэтому для простого письма лучше выбрать обычный режим.
Начните с 8B: сжатый файл занимает 5.2 ГБ и работает на ПК с 16 ГБ оперативной памяти. Версия 14B занимает 9 ГБ, а 32B требует более мощного компьютера. В каталоге Ollama выбирайте локальный файл. Пометка cloud означает, что запрос обрабатывает внешний сервер, поэтому нейросеть не работает полностью на вашем ПК.
Плюсы:
- Разбирает задачу на последовательные шаги.
- Объясняет фрагменты кода и возможные ошибки.
- Предлагает небольшую версию 8B.
- Работает офлайн после загрузки локального файла.
Минусы:
- Компактные версии не повторяют качество полной DeepSeek.
- Длинное рассуждение занимает время и память.
- Выбранные модели не читают картинки.
- Для автоматического исправления проекта нужен отдельный ИИ-агент.
4. GLM — решает сложные задачи на мощном ПК
GLM-4.7-Flash от Z.ai подходит для локальной работы с текстом, кодом и ИИ-агентами. Это вариант для ПК с 32+ ГБ памяти, а не облегченный чат-бот для старого ноутбука.
GLM-4.7-Flash использует для ответа только часть своих возможностей, но компьютеру все равно нужно загрузить файл целиком. Поэтому модель весит 19 ГБ и требует намного больше памяти, чем обычная версия 3B.
Сжатый файл GLM в Ollama занимает 19 ГБ. Нейросеть может разобрать техническое задание, найти противоречия, составить план и написать код. Чтобы читать и менять файлы на компьютере, ей нужна отдельная программа с таким доступом. Для домашнего запуска версия 4.7 Flash удобнее более крупных GLM.
GLM подойдет разработчикам и пользователям мощных ПК, которые хотят сравнить Qwen с другой моделью на своих заданиях.
Плюсы:
- Разбирает текстовые и программные задачи.
- Поддерживает обращения к инструментам ИИ-агента.
- Скачивается готовым сжатым файлом в Ollama.
- Не требует загружать полную огромную GLM.
Минусы:
- Файл на 19 ГБ слишком велик для большинства ПК с 16 ГБ RAM.
- Выбранная версия работает только с текстом.
- Большой контекст требует дополнительной памяти.
- Без отдельного агента не меняет файлы на компьютере.
5. Gemma — читает документы, работает с изображениями
У Google стоит выбрать Gemma 3 4B, Gemma 4 12B или Gemma 4 31B. 12B сочетает работу с изображениями и умеренный размер файла, а более старая 4B остается полезной для слабого ПК.
Gemma можно показать скриншот инструкции и попросить объяснить действия простыми словами. Другой пример — сравнить текст объявления с изображением товара и найти расхождения. Все три выбранные версии принимают изображения, но не рисуют новые картинки.
В Ollama Gemma 3 4B занимает 3.3 ГБ, Gemma 4 12B — 7.6 ГБ, а 31B — 20 ГБ. Для 12B нужно 16-32 ГБ оперативной памяти, для 31B — от 32 ГБ. Некоторые версии Gemma понимают звук, но эта функция работает только в программах, которые умеют передавать модели аудиофайлы.
Плюсы:
- Читает изображения вместе с вопросом пользователя.
- Работает с несколькими языками.
- Предлагает легкую версию для первого запуска.
- Запускается через LM Studio и Ollama.
Минусы:
- Не создает изображения по описанию.
- 31B требует мощного компьютера.
- Поддержка звука зависит от программы запуска.
- У разных поколений отличаются условия лицензии.
6. Mistral — быстро работает с текстами и изображениями
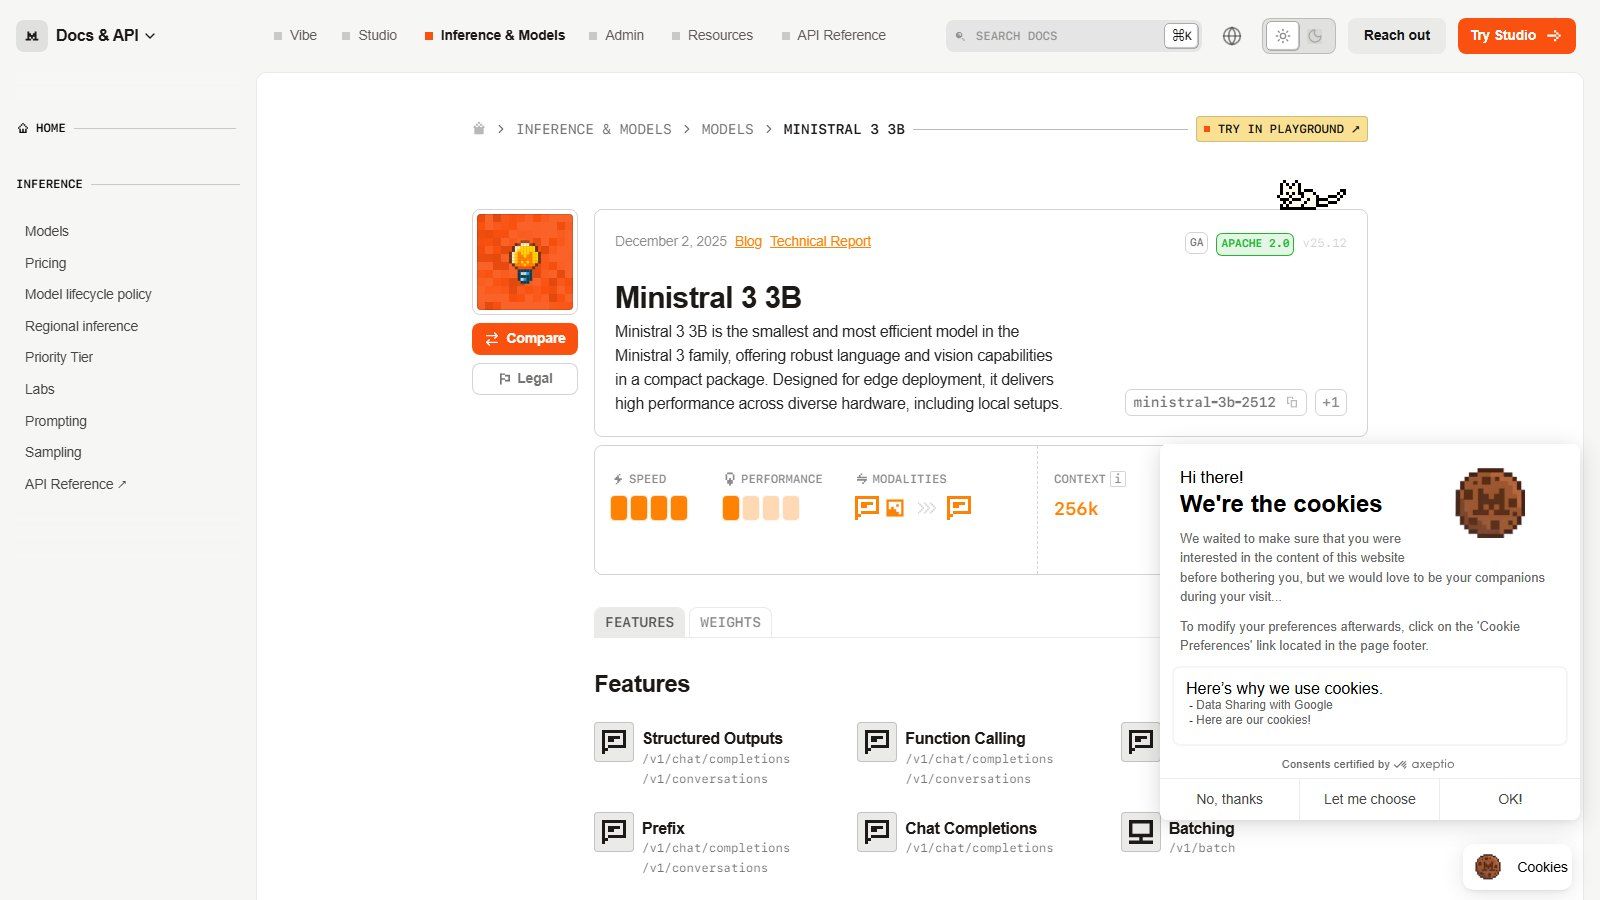
Для локального чата у Mistral AI есть Ministral 3 3B, 8B и 14B. Версия 8B удобна для повседневных задач, когда не хочется занимать моделью десятки гигабайт.
Ministral сокращает тексты, составляет письма и принимает изображения. Можно показать скриншот настроек и спросить, за что отвечает каждый пункт. Или вставить длинную переписку и попросить выписать только решения, сроки и открытые вопросы.
Файлы в Ollama занимают 3, 6 и 9.1 ГБ соответственно. Для 3B подойдет компьютер с 8-16 ГБ RAM, для 8B лучше иметь 16 ГБ. Версия 14B требует больше запаса, особенно с изображениями. Windows, macOS и Linux подходят при наличии совместимой программы и оборудования.
Плюсы:
- Пишет и сокращает тексты.
- Принимает текст и изображения в одном чате.
- Дает выбор из трех размеров.
- Подключается к программам, которые выполняют дополнительные действия.
Минусы:
- Не заменяет специализированную модель для большого проекта.
- Не генерирует картинки.
- 14B занимает втрое больше места, чем 3B.
- Большой заявленный контекст не помещается в память любого ноутбука.
7. Phi — объясняет математику и код на небольшом ПК
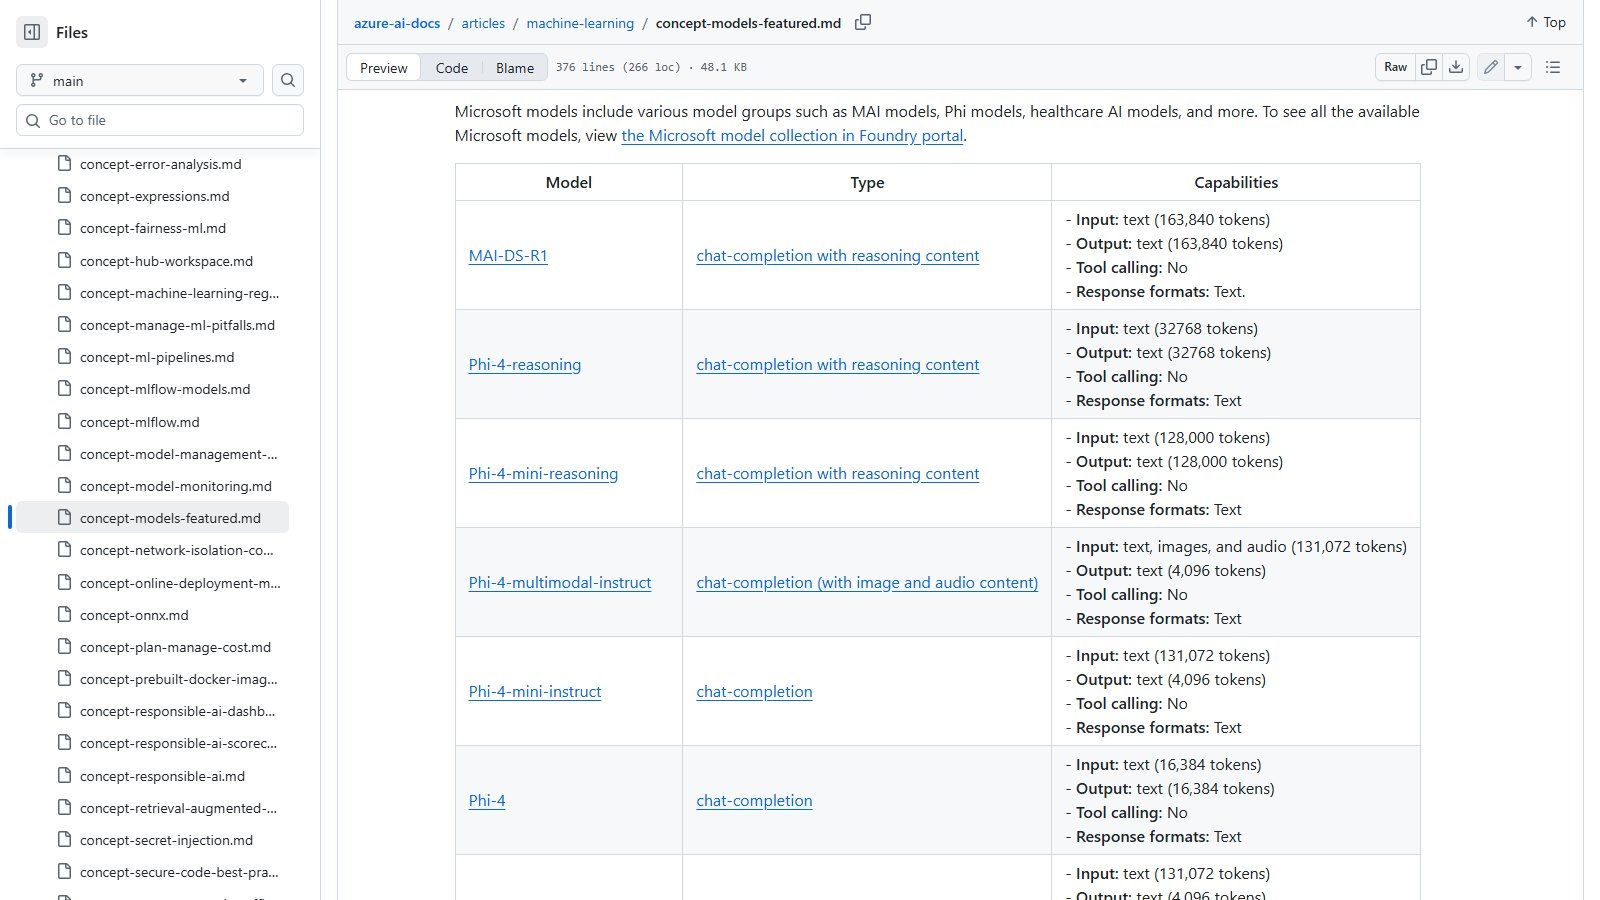
Phi-4 Mini и Phi-4 от Microsoft полезны для логических задач и объяснений. Mini занимает всего 2.5 ГБ в Ollama, поэтому с нее проще начать на компьютере с ограниченной памятью.
Нейросети можно дать формулу, условие задачи или несколько строк Python. Например, спросить, почему цикл не заканчивается, и попросить показать исправленный вариант. Важно не путать текстовый ответ с исполнением программы: проверку кода нужно запускать отдельно.
У Mini 3.8 млрд параметров, у обычной Phi-4 — 14 млрд. Сжатый файл старшей версии занимает 9.1 ГБ. Mini ориентирована на несколько языков, тогда как обычная Phi-4 прежде всего рассчитана на английский. Для русских писем Qwen или Gemma логичнее попробовать раньше.
Плюсы:
- Помещается небольшим файлом в версии Mini.
- Объясняет логические и математические задачи.
- Помогает разбирать короткие программы.
- Работает без подписки на облачный помощник Microsoft.
Минусы:
- Обычная Phi-4 ориентирована прежде всего на английский.
- Выбранные версии не читают изображения.
- У Phi-4 контекст короче, чем у многих новых моделей.
- Для запуска и проверки кода требуется другая программа.
8. Llama* — локальная нейросеть для слабого ноутбука
Llama* 3.2 3B, 3.1 8B и 3.3 70B остаются вариантами для локального текстового чата. Их сильная сторона — большой выбор совместимых программ и готовых файлов.
В Ollama файлы выбранных моделей занимают 2, 4.9 и 43 ГБ. Начните с 3B на небольшом ноутбуке или 8B на ПК с 16 ГБ RAM. Для 70B нужна рабочая станция с большим запасом памяти. Выбранные текстовые версии не распознают изображения, даже если другая модель Llama* это умеет.
Llama* подойдет для совместимости с уже настроенными локальными программами. Если главное — русский текст, сначала сравните результат с Qwen на одном и том же запросе.
Плюсы:
- Запускается в большинстве известных локальных оболочек.
- Предлагает небольшую версию 3B.
- Дает широкий выбор готовых сжатых файлов.
- Имеет много документации и примеров подключения.
Минусы:
- 70B не рассчитана на обычный ноутбук.
- Русский не входит в основной заявленный набор языков выбранных версий.
- Текстовые версии не читают скриншоты.
- Собственная лицензия требует отдельной проверки перед коммерческим внедрением.
9. Qwen Coder — локальная нейросеть для программирования
Для программирования подойдут Qwen2.5-Coder 7B, Qwen3-Coder 30B и Qwen3-Coder-Next. 30B — основной вариант для ПК с 32+ ГБ памяти, а 7B стоит оставить для более скромного компьютера.
Qwen Coder пишет функции, объясняет ошибки и предлагает правки для нескольких файлов. В обычном чате нейросеть только показывает новый код. Чтобы Qwen Coder сама меняла проект, подключите модель к редактору или ИИ-агенту с доступом к папке. Для сравнения, Claude Code используют 39% профессиональных разработчиков, но этот агент работает через облако.
Версия 30B занимает 19 ГБ в Ollama. Сжатый файл Coder-Next занимает уже 52 ГБ и рассчитан на рабочую станцию. Во время ответа Coder-Next использует только часть своих параметров, но компьютер все равно должен загрузить и хранить весь большой файл.
Плюсы:
- Пишет и объясняет программный код.
- Подключается к агентам для работы с файлами.
- Предлагает легкую версию 7B.
- Не требует платить за каждую попытку исправления локально.
Минусы:
- Coder-Next занимает десятки гигабайт.
- Компактная 7B относится к более старому поколению.
- Без агента модель только предлагает текст изменений.
- Выбранные версии не анализируют картинки интерфейса.
10. Devstral — для работы с кодом целого проекта
Devstral Small 2 24B от Mistral AI работает с кодом целого проекта. Через ИИ-агента модель находит связанные файлы, предлагает правки и запускает проверки программы.
Devstral может найти ошибку сразу в нескольких файлах, но для этого нужен ИИ-агент с доступом к проекту. Без агента нейросеть только пишет ответ в чате. Codex используют 20+ млн человек, и такой облачный агент проще запустить новичку, чем локальную связку Devstral с редактором.
Сжатый файл в Ollama занимает 15 ГБ. Среди подходящих компьютеров разработчик называет ПК с видеокартой RTX 4090 и Mac с 32 ГБ общей памяти. На менее мощном устройстве модель может работать медленно или не загрузиться. Devstral также принимает скриншоты, поэтому к описанию ошибки можно приложить изображение интерфейса.
Devstral подойдет разработчикам с мощным компьютером. Для простого объяснения пары строк кода достаточно более легкой модели.
Плюсы:
- Работает с задачами, которые затрагивают несколько файлов.
- Поддерживает инструменты программного агента.
- Принимает изображения вместе с текстовым заданием.
- Помещается на подходящей одиночной мощной видеокарте в сжатом виде.
Минусы:
- Требует больше памяти, чем компактные модели для кода.
- Не предоставляет готовый редактор вместе с файлом модели.
- Без настроенных инструментов не запускает тесты.
- Длинный проект увеличивает расход памяти сверх размера файла.
11. Qwen VL — отвечает на вопросы по тексту и изображениям
Qwen3-VL 4B, 8B и 32B отвечают на вопросы по тексту и изображениям. Буквы VL означают Vision Language — нейросеть видит картинку и объясняет ее словами.
Можно загрузить фотографию таблицы и попросить переписать строки в текст. Или показать скриншот программы и узнать, где поменять нужную настройку. Qwen VL также помогает описать график и объяснить, что изображено на схеме. Мелкие надписи на размытой фотографии лучше сначала сделать четче.
В Ollama версии 4B, 8B и 32B занимают 3.3, 6.1 и 21 ГБ. Для первого знакомства подойдет 4B или 8B, для старшей нужен ПК с 32+ ГБ RAM. Выбирайте программу, которая умеет передавать изображения именно этой модели. Обычное текстовое поле без загрузки файлов не откроет возможности зрения.
Плюсы:
- Объясняет изображения обычным текстом.
- Читает надписи и таблицы на картинках.
- Помогает разобраться в интерфейсе по скриншоту.
- Предлагает небольшие версии 4B и 8B.
Минусы:
- Не генерирует готовые изображения.
- Требует программы с поддержкой загрузки картинок.
- Размытые и мелкие надписи усложняют распознавание.
- Несколько больших изображений заметно увеличивают расход памяти.
12. Codestral — дописывает функции и исправляет отдельные участки кода
Codestral 22B от Mistral AI умеет вставлять недостающий код между готовыми строками. Например, можно оставить начало и конец функции, а нейросеть допишет середину. Здесь рассматривается скачиваемая версия 22B, а не облачный сервис с похожим названием.
Такой режим полезен, когда функция уже начата и нужно дописать середину, сохранив остальной код. Codestral также предлагает тесты и объясняет изменения. В отличие от Devstral, главная причина выбрать эту модель — работа с отдельными фрагментами и автодополнение в редакторе.
В Ollama сжатая версия занимает 13 ГБ. Для удобного запуска стоит иметь 24-32 ГБ RAM либо подходящую видеокарту с запасом памяти. Модель обучали на более чем 80 языках программирования. На популярных языках программирования результат обычно предсказуемее. Редкий язык лучше проверить на собственном примере.
Плюсы:
- Дописывает код между существующими фрагментами.
- Предлагает тесты для функций.
- Работает с десятками языков программирования.
- Скачивается готовым файлом через Ollama.
Минусы:
- Локальная 22B старше новых облачных Codestral.
- Лицензия не дает безусловного права на рабочее внедрение.
- Модель не читает изображения интерфейса.
- Для подсказок прямо в редакторе нужно настроить подключение.
13. Nemotron — для запуска ИИ-агента на вашем компьютере
Nemotron 3 Nano 4B и 30B от NVIDIA умеют рассуждать и обращаться к дополнительным инструментам. Версия 4B подходит для первого эксперимента, а 30B требует гораздо больше памяти.
Например, к Nemotron можно подключить программу, которая ищет файлы и выполняет расчеты. Нейросеть решает, когда вызвать нужную функцию, а затем использует результат в ответе. Сам файл модели не видит весь компьютер. Доступ к папкам и командам настраивают в программе-агенте.
У 4B файл в Ollama занимает 2.8 ГБ, у 30B — 24 ГБ. Поэтому слово Nano не означает, что любая версия поместится на слабом ноутбуке. Для 4B ориентируйтесь на 8-16 ГБ RAM, для 30B — на 48-64 ГБ с запасом под задачи. Русский не входит в основной перечисленный разработчиком набор языков семейства.
Плюсы:
- Обращается к подключенным инструментам.
- Меняет режим подробного рассуждения.
- Предлагает компактный файл 4B.
- Запускается локально без обязательного облака NVIDIA.
Минусы:
- 30B занимает 24 ГБ только на диске.
- Русский не входит в основной заявленный набор языков.
- Для действий нужен отдельный агент с настройками доступа.
- Текстовые версии не разбирают изображения.
14. Granite — хорошо работает с текстами
У IBM для ПК есть Granite 4 Micro 3B и Granite 4 Small Hybrid. Эти модели составляют письма, извлекают данные и классифицируют текст.
Granite может извлечь из письма номер заказа, определить тему обращения или собрать краткую сводку. Например, попросите вернуть три поля: покупатель, товар и срок. Для обработки папки писем понадобится программа, которая по очереди передаст модели тексты и сохранит ответы.
Плюсы:
- Извлекает нужные сведения из текста.
- Распределяет обращения по заданным категориям.
- Предлагает компактную версию Micro.
- Допускает коммерческое применение по Apache 2.0.
Минусы:
- Русский отсутствует в основном заявленном наборе языков.
- Для обработки целой папки нужна дополнительная программа.
- Выбранные версии не читают изображения.
- Small Hybrid значительно тяжелее Micro, несмотря на слово Small.
15. Command R — отвечает по собственной базе документов
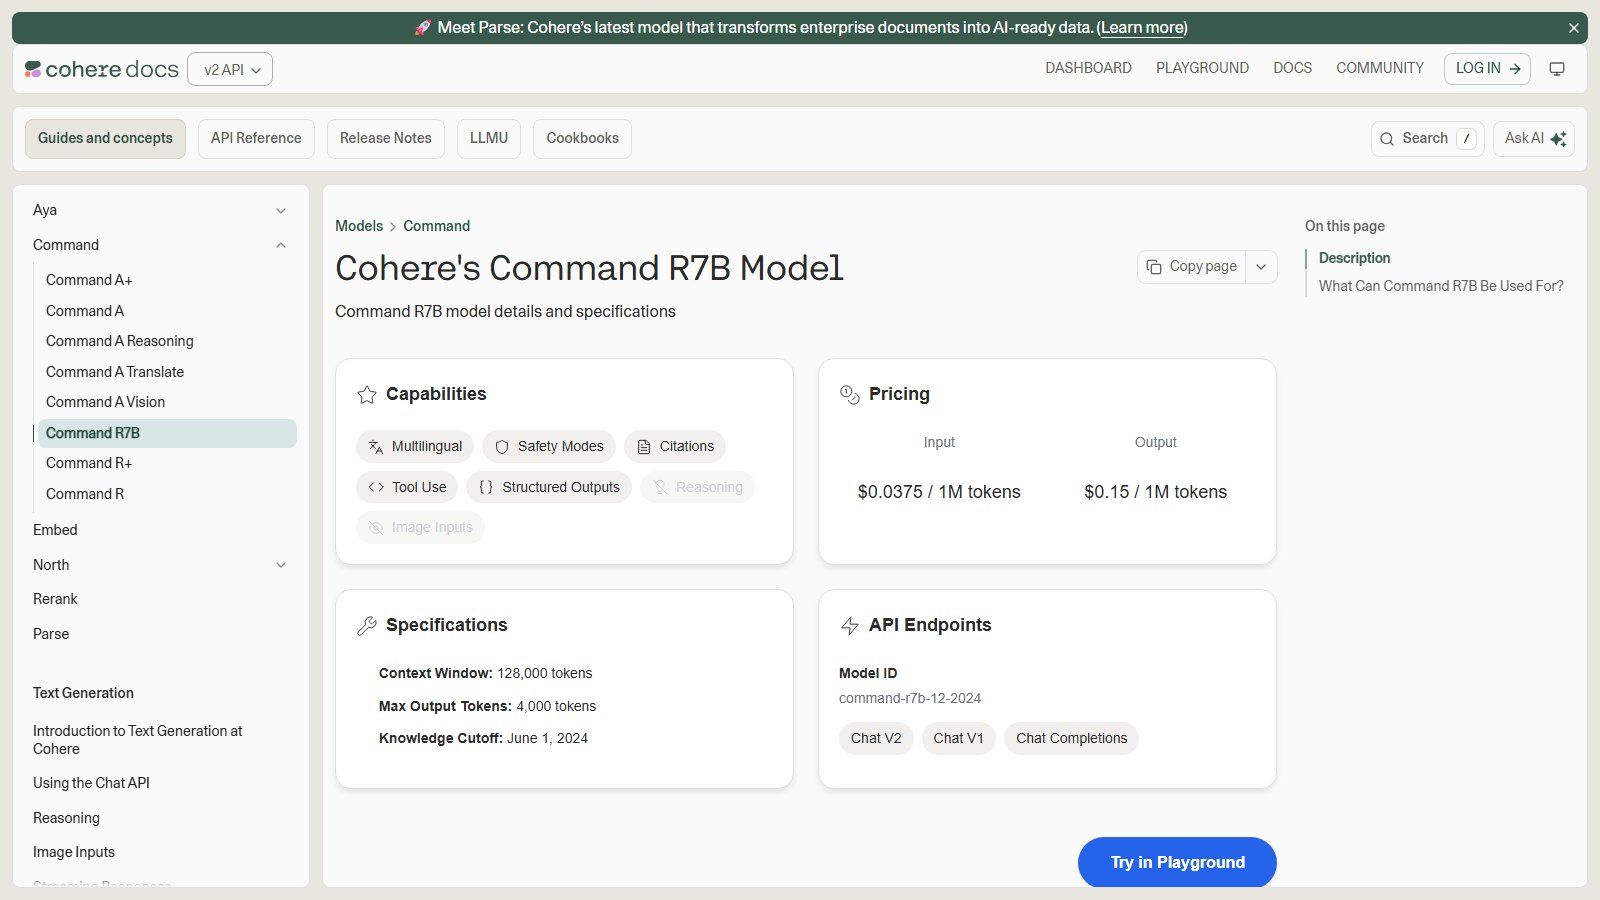
Command R7B от Cohere обучена работать с материалами, которые получает вместе с вопросом. Главная задача — найти и объяснить ответ по вашим документам, а не сочинить его только из общих знаний.
Перед ответом программа сначала находит подходящие отрывки в ваших файлах, а затем передает их Command R. Такой способ называют RAG, или ответом с поиском по документам. Например, программа найдет в инструкции правила возврата, а нейросеть объяснит их покупателю и укажет нужный фрагмент.
Сжатый файл R7B в Ollama занимает 5.1 ГБ. Для начала подойдет ПК с 16 ГБ оперативной памяти. Чтобы задавать вопросы по целой папке, установите программу с поиском по документам, например AnythingLLM. Простое скачивание модели не дает ей доступ к файлам на диске. Русский входит в поддерживаемые языки.
Плюсы:
- Отвечает по переданным фрагментам документов.
- Поддерживает ссылки на предоставленные материалы.
- Работает с русским текстом.
- Помещается в компактной версии R7B.
Минусы:
- Бесплатная лицензия исключает коммерческое использование.
- Поиск по папкам нужно настраивать отдельно.
- Ошибки при чтении исходного файла переходят в ответ.
- Выбранная модель не распознает фотографии страниц сама.
16. SmolLM — чат-бот на слабом компьютере
SmolLM2 1.7B и SmolLM3 3B от Hugging Face рассчитаны на небольшой размер. SmolLM2 стоит попробовать на слабом компьютере, если более тяжелые варианты не загружаются.
Разумные задачи — короткий ответ, простое объяснение, небольшой пересказ на английском. Например, можно попросить сократить абзац до трех предложений. Для сложного договора или проекта из множества файлов такую модель выбирать не стоит.
Файл SmolLM2 1.7B занимает 1.8 ГБ в Ollama. Пометка Q8 означает, что модель сжали умеренно: файл крупнее версии Q4, зато теряет меньше точности. SmolLM3 новее и умеет показывать рассуждение по шагам. Русского среди шести основных языков SmolLM3 нет.
Плюсы:
- Занимает мало места в версии 1.7B.
- Работает с короткими текстами без интернета.
- Предлагает более новую версию 3B с рассуждениями.
- Не требует подписки для локальных запросов.
Минусы:
- Русский не входит в основной набор языков SmolLM3.
- Версия 1.7B относится к предыдущему поколению.
- Небольшой размер ограничивает сложность подходящих задач.
- Текстовые модели не читают картинки и не распознают речь.
17. MiniMax — ИИ выполняет сложные задачи на мощном ПК
MiniMax-M2.7 — крупная открытая модель для кода и многошаговых задач. Для обычного домашнего ПК этот вариант не подходит: даже сжатые сборки требуют огромного запаса памяти.
MiniMax разбирает код, документы и журналы ошибок — записи о работе программы. Через ИИ-агента модель может найти причину сбоя, предложить правки и запустить проверку. Для этого нужно отдельно установить программу-агент и разрешить ей доступ только к нужным файлам и командам.
У MiniMax-M2.7 примерно 230 млрд параметров. Даже сильно сжатая версия занимает больше 100 ГБ, а во время работы понадобится дополнительная память. Перед скачиванием проверьте точный размер файла и требования выбранной сборки.
MiniMax подойдет владельцам мощных рабочих ПК и опытным разработчикам.
Плюсы:
- Работает со сложными задачами программирования.
- Поддерживает инструменты для многошаговой работы.
- Дает доступ к весам для самостоятельного запуска.
- Разбирает технические тексты и журналы ошибок.
Минусы:
- Не помещается в память обычного ноутбука.
- Требует очень большого места на диске.
- Запуск нуждается в проверке конкретной сборки и оборудования.
- Без отдельного агента не создает готовые офисные файлы.
18. Kimi — анализирует документы и изображения
Для своего компьютера у Moonshot AI интересны Kimi VL Thinking 2506 и Kimi Linear 48B. Первая версия работает с изображениями, а вторая ориентирована на длинные текстовые запросы.
Kimi VL можно показать диаграмму и попросить объяснить ее простыми словами. В названии A3B буква A означает активные параметры: при каждом ответе модель использует около 3 млрд из 16 млрд. Компьютеру все равно приходится хранить всю модель. Kimi Linear содержит 48 млрд параметров и требует более мощного устройства.
Новичку проще начать с Qwen VL. Перед установкой Kimi проверьте, поддерживает ли программа выбранную версию и сколько весит сжатый файл. Даже Kimi VL требует десятки гигабайт памяти без сжатия.
Kimi подойдет опытному пользователю, которому нужен отдельный вариант для длинных документов или визуальных задач. Это не самый простой способ впервые установить нейросеть на ПК.
Плюсы:
- Разбирает изображения в версии VL.
- Предлагает отдельную модель Linear для длинного текста.
- Рассуждает над вопросами с несколькими условиями.
- Скачивается для самостоятельного запуска.
Минусы:
- A3B не означает размер всей модели в 3 млрд параметров.
- Linear 48B требует много памяти.
- Совместимость зависит от конкретной программы и сборки.
- Заявленный длинный контекст не гарантирует работу на слабом ПК.
19. InternLM — текстовая ИИ-модель с режимом рассуждений
InternLM3 8B Instruct от Shanghai AI Laboratory — текстовая ИИ-модель с режимом рассуждений. Это альтернатива для сравнения с другими моделями 8B, а не обязательная замена уже удобному Qwen.
InternLM можно попросить проверить аргументы в тексте или объяснить последовательность действий. Основные языки и примеры разработчика — английский и китайский. Если все ваши задачи на русском, это заметное ограничение при выборе первого локального чат-бота.
InternLM можно запустить через Ollama. Выбирайте готовую сжатую версию: она занимает меньше памяти, чем исходные файлы модели общим размером около 17.6 ГБ. Число 8B показывает количество параметров, но не размер загрузки. Для сжатой версии лучше иметь 16 ГБ оперативной памяти.
Плюсы:
- Переключается между обычным ответом и рассуждением.
- Работает с английским и китайским текстом.
- Имеет официальный пример локального запуска.
- Допускает коммерческое применение по Apache 2.0.
Минусы:
- Русский не относится к основным языкам модели.
- Исходные файлы значительно тяжелее сжатой сборки.
- Модель не принимает изображения.
- Для некоторых способов запуска нужно устанавливать дополнительные библиотеки.
20. Aya — переводит тексты на разные языки
Aya Expanse 8B и 32B от Cohere Labs ориентированы на работу с 23 языками, включая русский. Это полезнее для перевода и переписки, чем выбор модели, которая знает русский лишь попутно.
Aya можно попросить перевести письмо, сохранить деловой тон и объяснить неоднозначную фразу. Другой сценарий — пересказать иностранную статью по-русски. Для названий, сумм и специальных терминов задавайте точные требования, особенно если перевод уйдет другому человеку.
В Ollama версии 8B и 32B занимают 5.1 и 20 ГБ. Для первой удобен ПК с 16 ГБ RAM, для второй — 32+ ГБ. Обе выбранные версии текстовые. Чтобы перевести фотографию документа, сначала нужно распознать надписи либо выбрать другую модель с поддержкой изображений.
Плюсы:
- Работает с русским среди основных поддерживаемых языков.
- Переводит и пересказывает иностранные тексты.
- Объясняет смысл фраз в контексте письма.
- Предлагает компактную версию 8B.
Минусы:
- Бесплатная лицензия ограничена некоммерческим использованием.
- 32B требует значительно больше памяти.
- Выбранные версии не читают фотографии документов.
- Для длинного текста нужно учитывать контекст конкретной версии.
Какую нейросеть выбрать для компьютера
Для первого запуска локальной нейросети не нужна дорогая видеокарта. На ноутбуке с 8 ГБ памяти можно попробовать небольшую текстовую модель, а с 16 ГБ выбор заметно шире. Без видеокарты ответы будут приходить медленнее, потому что вычисления возьмет на себя процессор.
В таблице указаны примерные требования для сжатых моделей и короткого диалога. Часть оперативной памяти уже занята Windows, браузером и программой запуска. Большая книга, несколько изображений и длинная переписка потребуют дополнительной памяти.
Какие локальные нейросети выбрать по объему оперативной памяти:
| Память компьютера | С чего начать | Что можно делать |
|---|---|---|
| 4 ГБ | SmolLM2 1.7B в сжатом формате, если хватает свободной памяти | Задать короткий вопрос на английском |
| 8 ГБ | Phi-4 Mini, Qwen3.5 4B | Обсудить небольшой текст или пример кода |
| 16 ГБ | Qwen3.5 9B, DeepSeek R1 8B, Ministral 3 8B | Писать тексты и разбирать рабочие вопросы |
| 24-32 ГБ | gpt-oss-20b, Gemma 4 12B, Qwen3.5 27B | Сравнить несколько документов и решить сложную задачу |
| 32-64 ГБ | GLM-4.7-Flash, Devstral Small 2, Qwen3-Coder 30B | Работать с кодом проекта и длинными запросами |
| 64-128 ГБ | Qwen3-Coder-Next, Llama* 3.3 70B, gpt-oss-120b с достаточным запасом | Запускать крупные модели на рабочей станции |
Сколько памяти нужно локальной нейросети
Обозначение 9B означает 9 млрд параметров, а не 9 ГБ памяти. Параметры — это настройки, по которым нейросеть строит ответ. Размер скачиваемого файла зависит от числа параметров и степени сжатия.
Квантование — это сжатие нейросети. Версия Q4_K_M занимает меньше места и подходит для первого запуска. Q8 обычно отвечает точнее, но требует почти вдвое больше памяти.
RAM — оперативная память компьютера, VRAM — память видеокарты. Нейросеть работает быстрее, когда целиком помещается в VRAM. Если места не хватает, часть данных переходит в обычную память и ответы приходят медленнее. В компьютерах Mac с чипами Apple память общая.
SSD хранит файл, а оперативная память запускает нейросеть. Windows и другие программы тоже занимают RAM, поэтому для файла размером 14 ГБ нужно больше 16 ГБ оперативной памяти.
Контекст — это текущий вопрос, документы и предыдущие сообщения, которые нейросеть держит в памяти. Длинный разговор и большие файлы замедляют работу. Начните с короткого запроса, а документы добавляйте после проверки скорости.
Размеры готовых файлов в каталоге Ollama:
| Локальная ИИ-модель | Файл для скачивания | Версия файла |
|---|---|---|
| Phi-4 Mini | 2.5 ГБ | Стандартная сжатая версия |
| Qwen3.5 4B | 3.4 ГБ | Q4_K_M |
| DeepSeek R1 8B | 5.2 ГБ | Q4_K_M |
| Qwen3.5 9B | 6.6 ГБ | Q4_K_M |
| Gemma 4 12B | 7.6 ГБ | Стандартная сжатая версия |
| gpt-oss-20b | 14 ГБ | MXFP4 |
| GLM-4.7-Flash | 19 ГБ | Q4_K_M |
| gpt-oss-120b | 65 ГБ | MXFP4 |
Какая локальная нейросеть лучше для разных задач
Для одного компьютера можно держать несколько моделей и загружать нужную по очереди. Например, Qwen — для текста, а Qwen Coder — для программирования. Файлы занимают место на диске, но не обязаны одновременно находиться в оперативной памяти.
Модель для кода особенно полезна вместе с редактором или ИИ-агентом. При вайбкодинге человек описывает программу обычными словами, а нейросеть пишет и исправляет код. Но локальная модель сама по себе только выводит текст ответа. Читать папку проекта, сохранять файлы и запускать проверки должна подключенная программа.
Какие нейросети выбрать для типичных задач на компьютере:
| Задача | Что выбрать | Что проверить |
|---|---|---|
| Написать или сократить русский текст | Qwen, Gemma | Начать с 4B-12B по памяти ПК |
| Разобрать задачу по шагам | DeepSeek, GLM | Оставить время на рассуждение |
| Написать код или исправить проект | Qwen Coder, Devstral | Подключить редактор или агента |
| Запустить ИИ на слабом ноутбуке | Phi Mini, SmolLM, небольшая Gemma | Ограничить длину запроса |
| Прочитать скриншот или схему | Qwen VL, Gemma | Выбрать интерфейс с загрузкой изображений |
| Найти ответ по личным документам | Command R | Подключить поиск по файлам |
| Работать с моделью OpenAI локально | gpt-oss-20b | Выделить достаточно памяти |
| Перевести текст между языками | Aya | Проверить лицензию для коммерческой работы |
| Подключить модель к знакомой локальной программе | Llama* | Проверить нужный язык и размер версии |
Лучшие программы для запуска нейросетей на ПК
Новичку удобнее начать с LM Studio: программа сама показывает каталог моделей, скачивает выбранный файл и открывает окно чата. На Windows желательно иметь не менее 16 ГБ оперативной памяти. На старом ПК проверьте требования к процессору, а на Mac скачайте версию для чипов Apple.
ИИ-модель и программа запуска — разные вещи. Модель — это большой файл со знаниями и настройками. LM Studio, Ollama или другая программа загружает этот файл в память, показывает чат и передает нейросети документы. Поэтому одна модель может работать в нескольких программах.
Программы для локального запуска нейросетей:
| Программа | Что можно сделать | Для кого |
|---|---|---|
| LM Studio | Скачать модель и общаться в окне чата | Новичкам |
| Ollama | Запустить модель и подключить к другой программе | Пользователям локального ИИ и разработчикам |
| Jan | Общаться с локальной моделью в настольном приложении | Пользователям, которым нужен открытый интерфейс чата |
| GPT4All | Задать вопросы модели и своим документам | Новичкам с простыми текстовыми задачами |
| Open WebUI | Открыть собственный чат в браузере | Опытным пользователям и небольшим командам |
| AnythingLLM | Собрать чат по папке документов | Пользователям личной базы знаний |
| llama.cpp | Настроить запуск и распределить модель между процессором и видеокартой | Разработчикам и опытным пользователям |
Как скачать и запустить локальную нейросеть
Сначала установите программу, затем скачайте модель. Например, откройте официальный сайт LM Studio, выберите приложение для своей системы и найдите Qwen нужного размера во встроенном каталоге. Перед загрузкой проверьте размер файла и подсказку о совместимости с компьютером.
Для обычного диалога выбирайте вариант Instruct или Chat — такую модель уже научили отвечать на вопросы пользователя. Пометка Base означает исходную модель для дальнейшей настройки и новичку обычно не нужна. GGUF — распространенный формат файла для локального запуска. Перед скачиванием убедитесь, что LM Studio или другая выбранная программа поддерживает именно эту модель.
После загрузки откройте новый разговор и задайте короткий вопрос. Например, попросите переписать абзац простыми словами. Если компьютер заметно тормозит, сначала выберите меньшую модель или сократите контекст. Не стоит сразу пытаться загрузить всю книгу.
В Ollama локальный Qwen запускается командой ollama run qwen3.5:4b. Ее вводят в командной строке — окне, где компьютеру дают текстовые команды. Ollama сам скачает файл и откроет диалог. Пометка cloud означает, что ответ готовит внешний сервер, а не ваш ПК.
На компьютере могут пригодиться и другие открытые программы. Например, Open WebUI создает браузерный чат для локальных моделей, а AnythingLLM добавляет работу с документами. Эти инструменты не меняют требования самой нейросети к памяти.
Работают ли локальные нейросети без интернета
После скачивания модель может отвечать без интернета. Текст, который вы передаете полностью локальному чату, не нужно отправлять разработчику модели. Но поиск в интернете, облачная нейросеть и внешние инструменты агента уже требуют соединения.
Личный документ остается на компьютере, только если программа использует локальную модель. Облачный вариант с тем же названием отправит запрос на внешний сервер.
Для проверки отключите интернет и отправьте простой текстовый запрос. Если ответ пришел, сама генерация работает на устройстве. Так вы проверите только локальную работу модели. Затем посмотрите, какие внешние службы, плагины и папки использует программа.
Для поиска по документам программа часто использует вторую небольшую нейросеть. Она сравнивает смысл вопроса с отрывками из файлов и находит подходящий текст. Если важна полная работа без внешних серверов, эта поисковая модель тоже должна запускаться на компьютере.
Что такое локальная нейросеть
Локальная нейросеть — это ИИ-модель, которую запускают на своем устройстве. Представьте обычный чат-бот, только ответ готовит ваш компьютер, а не сервер чужой компании. Для этого нужно скачать файл модели и открыть его в совместимой программе.
Одна и та же марка может обозначать и сайт с чат-ботом, и отдельную модель для скачивания. Например, у DeepSeek есть чат-бот и открытые ИИ-модели. Установка компактной DeepSeek не переносит на ноутбук весь облачный чат со всеми возможностями.
Открытые веса означают, что готовый файл нейросети можно скачать и запустить самостоятельно. Это не гарантирует открытый код программы и не всегда разрешает коммерческое использование. Перед установкой проверьте три вещи: доступен ли файл, хватит ли памяти компьютера и разрешает ли лицензия вашу задачу.
Заключение
Для первого локального чат-бота начните с Qwen3.5 4B или 9B в LM Studio. Если нужны рассуждения, попробуйте DeepSeek R1 8B. Для мощного ПК и программирования присмотритесь к Qwen Coder или Devstral, но заранее выберите программу, которая будет работать с файлами проекта.
Не покупайте новую видеокарту до первого теста. Проверьте модель на своих письмах, документах или коде, затем решайте, стоит ли ускорение расходов. Небольшая нейросеть, которая уверенно выполняет вашу задачу, полезнее огромного файла, который компьютер едва загружает.
* Llama принадлежит компании Meta, деятельность которой признана экстремистской и запрещена в России.
** Компания Meta признана экстремистской и запрещена в России.
Присоединяйтесь к ✨19 000+ подписчиков в телеграм-канале Бегин (или макс-канал), где я рассказываю, как использовать ИИ в бизнесе.